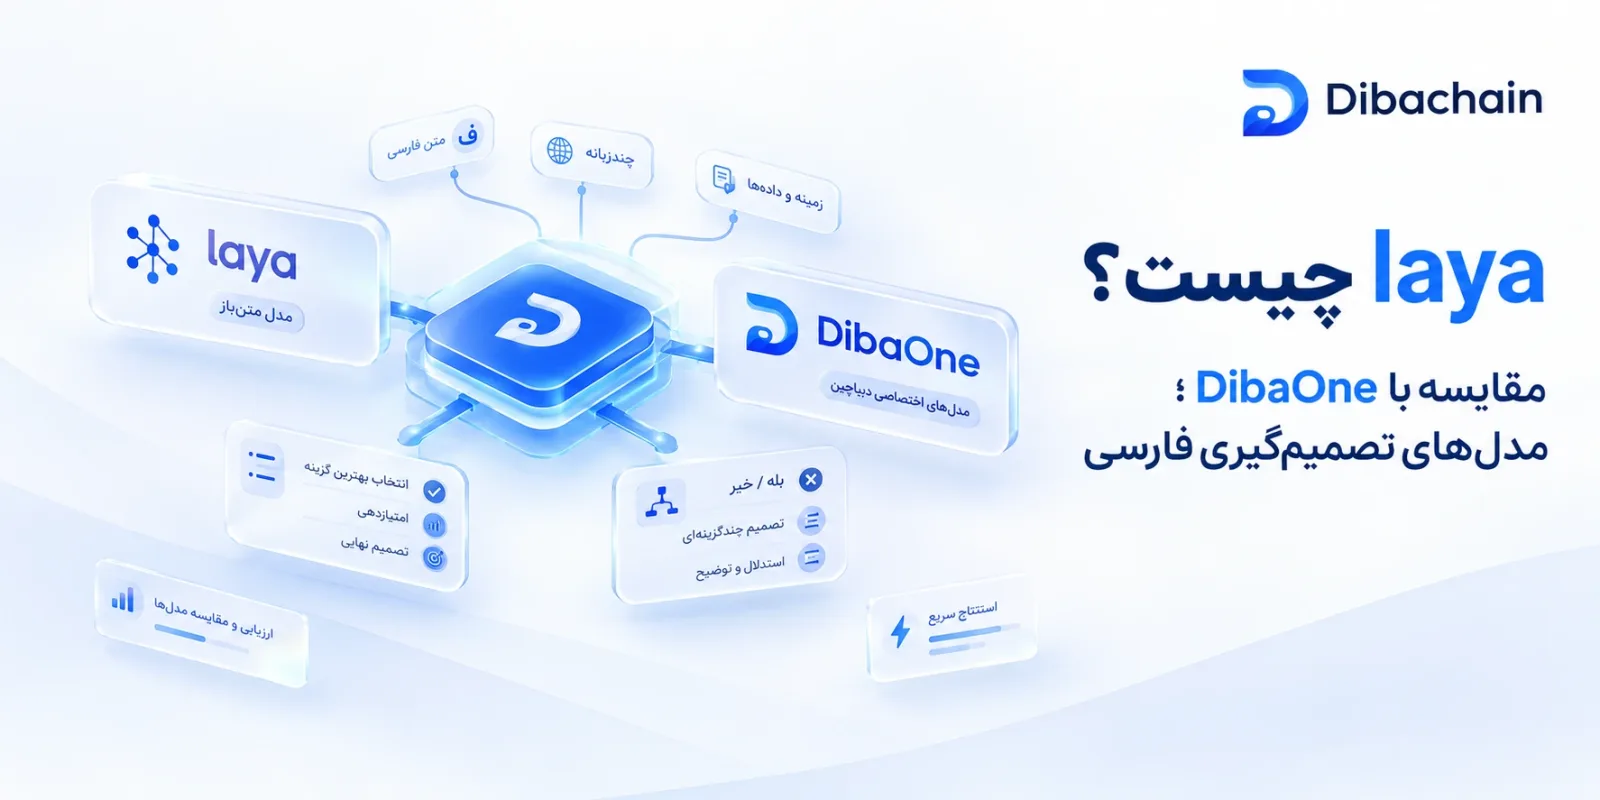
وقتی از «مدلهای هوش مصنوعی» حرف میزنیم، اغلب ذهنمان سراغِ مدلهایی میرود که متن تولید میکنند. اما دستهای کمتر سروصدا اما بسیار پرکاربرد هم وجود دارد: مدلهای تصمیمگیری. یکی از شناختهشدهترین نمونههای متنبازِ این دسته، laya است — و در همین حوزه، دیباچین با خانوادهٔ DibaOne واردِ رقابت شده است.
laya چیست؟
laya یک مدلِ تصمیمگیریِ چندگزینهایِ متنباز (با مجوز Apache-2.0) ساختهی convaiinnovations است. برخلافِ مدلهای زبانیِ بزرگ که پاسخ را بهصورتِ متنِ آزاد مینویسند، laya یک پرسش و مجموعهای از گزینهها میگیرد و همهٔ گزینهها را در یک گذر (one forward pass) امتیاز میدهد و بهترین را برمیگرداند. پاسخهایش نوعدار است: انتخابِ یک گزینه (choice)، امتیازدهی (score) یا بله/خیر. نسخهٔ چندزبانهٔ آن روی طیفی از زبانها کار میکند و بسیار سریع است (حدود ۲۷ میلیثانیه برای هر پرسش روی یک GPU از نوع T4).
اصلاً «مدل تصمیمگیری» یعنی چه؟
در بسیاری از سامانههای هوش مصنوعی، کارِ اصلی «نوشتن» نیست، «انتخاب» است: کدام ابزار صدا زده شود؟ این تیکت به کدام تیم برود؟ این نظر مثبت است یا منفی؟ این گزاره با متن میخواند یا نه؟ برای این کارها، صدا زدنِ یک مدلِ زبانیِ بزرگِ کامل هم گران است و هم ریسکِ توهم و خروجیِ بدقواره دارد. مدلِ تصمیمگیری دقیقاً همینجا میدرخشد: خروجیاش یک گزینهٔ مشخص بههمراهِ یک اطمینانِ عددی است، نه متنِ آزاد. چیزی برای «تجزیه» نیست و چیزی برای «توهم» هم نیست.
laya در برابر DibaOne (اعداد واقعی)
دیباچین خانوادهٔ DibaOne را بهطور خاص برای تصمیمگیریِ فارسیمحور ساخته و روی بنچمارکهای یکسان با laya سنجیده است. نکتهٔ مهمِ صداقت: laya روی این وظایف بهصورتِ zero-shot (بدونِ آموزش) سنجیده شد، در حالیکه DibaOne روی همین خانوادهها آموزش دیده است؛ پس این جدول نشان میدهد آموزشِ اختصاصیِ فارسی چهقدر تفاوت میسازد:
| وظیفه (دقتِ انتخابِ اول) | DibaOne | laya (zero-shot) |
|---|---|---|
| ابزارخوانیِ عامل — X1 | ۰٫۷۵۱ | ۰٫۱۷۶ |
| تصمیمهای مسیرِ توسعه — X1 | ۰٫۷۶۷ | ۰٫۳۳۶ |
| ارزیابیِ فارسیِ بومی (۱۰٬۷۶۶ پرسش) — M3 | ۰٫۷۳۸ | ۰٫۴۷۰ |
| خطای کالیبراسیون فارسی (ECE، کمتر بهتر) — M3 | ۰٫۰۱۰ | ۰٫۲۵۱ |
در ابزارخوانی، DibaOne X1 حدود ۴٫۳ برابر و در تصمیمهای توسعه حدود ۲٫۲ برابرِ laya دقت دارد؛ و روی فارسیِ بومی، M3 نزدیک به ۱٫۶ برابر دقیقتر است و اطمینانش (کالیبراسیون) دهها برابر قابلاعتمادتر. جزئیاتِ کاملِ هر جدول در صفحهٔ DibaOne X1 و DibaOne M3 آمده است.
پس کِی laya، کِی DibaOne؟
باید منصف بود: laya سریعتر است — چون همهٔ گزینهها را در یک گذر میخواند، در حالیکه کراسانکودرِ X1 هر گزینه را جداگانه با متن میسنجد. اگر به تصمیمهای زیرِ ۵۰ میلیثانیه نیاز دارید و وظیفهتان به دادهٔ آموزشیِ laya نزدیک است، این سرعت یک مزیتِ واقعی است. اما اگر روی فارسی کار میکنید و به دقتِ بالا در ابزارخوانیِ عامل و تصمیمهای ساختارمند نیاز دارید، DibaOne با آموزشِ اختصاصیِ فارسی بهمراتب جلوتر است.
پرسشهای متداول
laya چه کاری انجام میدهد؟
laya یک مدلِ تصمیمگیریِ چندگزینهایِ متنباز است که همهٔ گزینههای یک پرسش را در یک گذر امتیاز میدهد و بهترین را با نوعِ پاسخِ choice/score/yes-no برمیگرداند؛ متن تولید نمیکند.
DibaOne نسبت به laya چه مزیتی دارد؟
DibaOne بهطور اختصاصی روی فارسی و وظایفِ تصمیمگیری آموزش دیده و در ابزارخوانی حدود ۴٫۳ برابر و در تصمیمهای توسعه حدود ۲٫۲ برابرِ laya دقت دارد؛ laya در عوض سریعتر است.
مدل تصمیمگیری بهتر است یا مدل زبانی بزرگ؟
برای «انتخاب» (ابزار، مسیریابی، طبقهبندی)، مدلِ تصمیمگیری ارزانتر، سریعتر و بدونِ توهم است. برای «تولیدِ متن» به مدلِ زبانی نیاز دارید. اغلب این دو را کنارِ هم به کار میبرند.
منابع معتبر و مطالعهٔ بیشتر
- laya روی Hugging Face (convaiinnovations)
- کارت رسمی DibaOne X1
- صفحهٔ DibaOne X1 در دیباچین
- صفحهٔ DibaOne M3 در دیباچین
نقش دیباچین
مدلهای DibaOne و دیبا ساختهٔ دیباچین است. اگر میخواهید یک مدلِ تصمیمگیری را در عامل یا محصولتان بهکار بگیرید، روی دادهٔ خودتان تنظیم کنید یا معماریِ ترکیبیِ LLM + تصمیمگیر بسازید، با ما تماس بگیرید و همهٔ مدلهای دیباچین را ببینید.