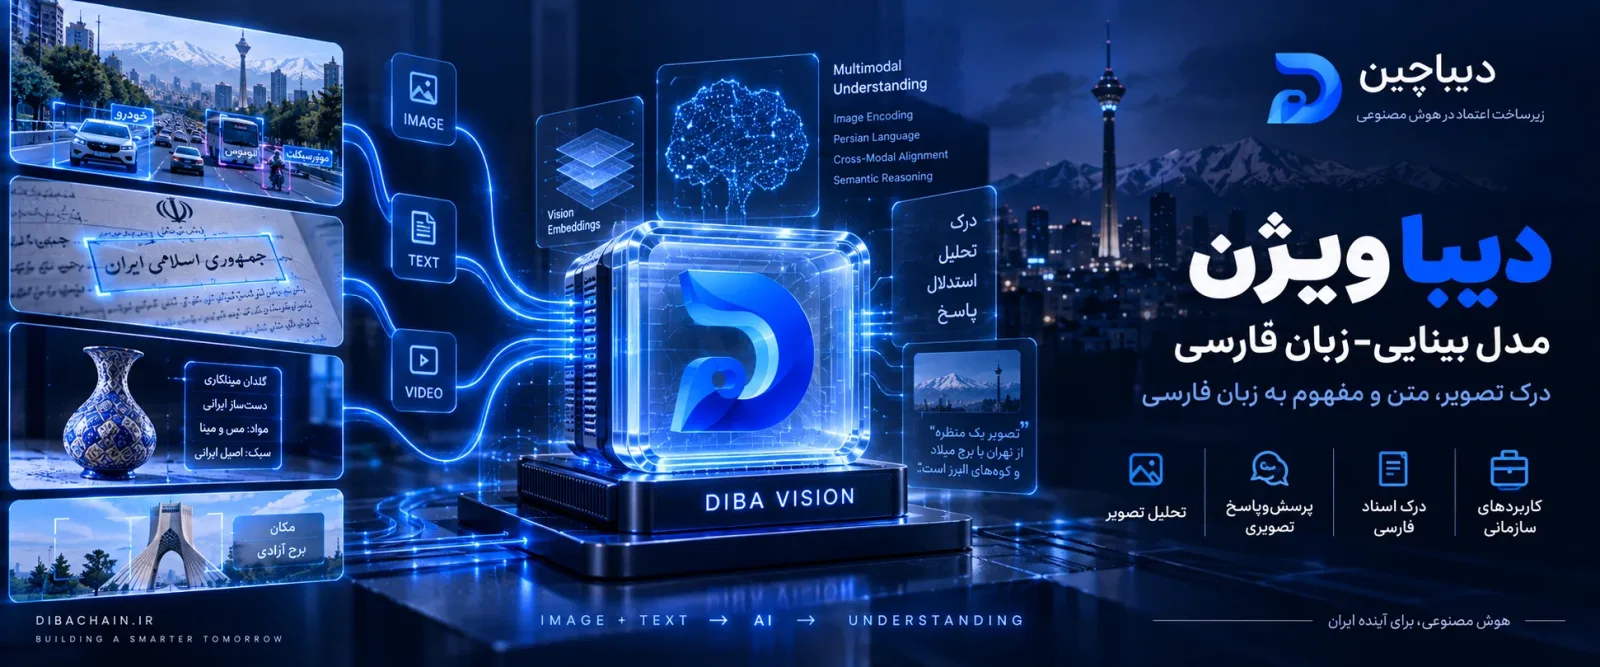
بیشترِ مدلهای بینایی متنباز وقتی پای فارسی وسط میآید کم میآورند. دیبا-ویژن — مدل بینایی-زبانیِ فارسیمحورِ دیباچین — عکس را میبیند و روان دربارهٔ آن به فارسی و انگلیسی پاسخ میدهد.
دیبا-ویژن چه کاری انجام میدهد؟
این مدلِ حدود ۴ میلیارد پارامتری، درکِ تصویریِ یک رمزگذارِ چندحالتهٔ قوی را با توانِ زبانِ فارسیِ خانوادهٔ دیبا ترکیب میکند و میتواند: تصویر را به فارسی توصیف کند، متنِ داخلِ تصویر (تابلو، سند، فرم) را با درکی شبیه OCR بخواند، اسکرینشاتِ رابط کاربری و کد و نمودار را تحلیل کند، و به پرسش دربارهٔ عکس پاسخ دهد.
کجا به کار میآید؟
از پشتیبانیِ مشتری که عکسِ محصولِ معیوب میفرستد، تا پردازشِ اسنادِ فارسی، کنترلِ کیفیت و دستیارهای دیداری. دیبا-ویژن ورودیِ چندتصویری و گفتوگوی چندمرحلهای را پشتیبانی میکند و خروجی را به همان زبانِ پرسشِ شما میدهد. برای گفتوگوی متنی و کد از دیبا و برای جستوجوی معنایی از دیبا-امبد استفاده کنید.
پرسشهای متداول
دیبا-ویژن متن فارسیِ داخلِ تصویر را میخواند؟
بله؛ میتواند تابلوها، اسناد و فرمهای فارسی و انگلیسی را با درکی شبیه OCR بخواند، هرچند متنهای بسیار ریز یا اسکنهای بیکیفیت ممکن است اشتباه خوانده شوند.
آیا دیبا-ویژن تصویر تولید میکند؟
خیر؛ این مدل برای درکِ تصویر و پاسخ دربارهٔ آن است، نه تولیدِ تصویر.
منابع معتبر و مطالعهٔ بیشتر
نقش دیباچین
مدلهای خانوادهٔ دیبا ساختهٔ دیباچین است؛ اگر میخواهید این مدلها را روی زیرساختِ خودتان مستقر کنید، روی دادهٔ سازمانی تنظیم کنید یا در محصولتان بهکار بگیرید، با ما تماس بگیرید و همهٔ مدلهای دیباچین را ببینید.