قلبِ هر سامانهٔ جستوجوی معنایی و هر RAGِ خوب، یک مدلِ امبدینگِ قدرتمند است. اما بیشترِ مدلهای امبدینگِ متنباز روی فارسی ضعیف عمل میکنند. دیبا-امبد — نخستین مدل امبدینگِ دیباچین — دقیقاً برای پر کردنِ همین شکاف ساخته شده است.
دیبا-امبد چه میکند؟
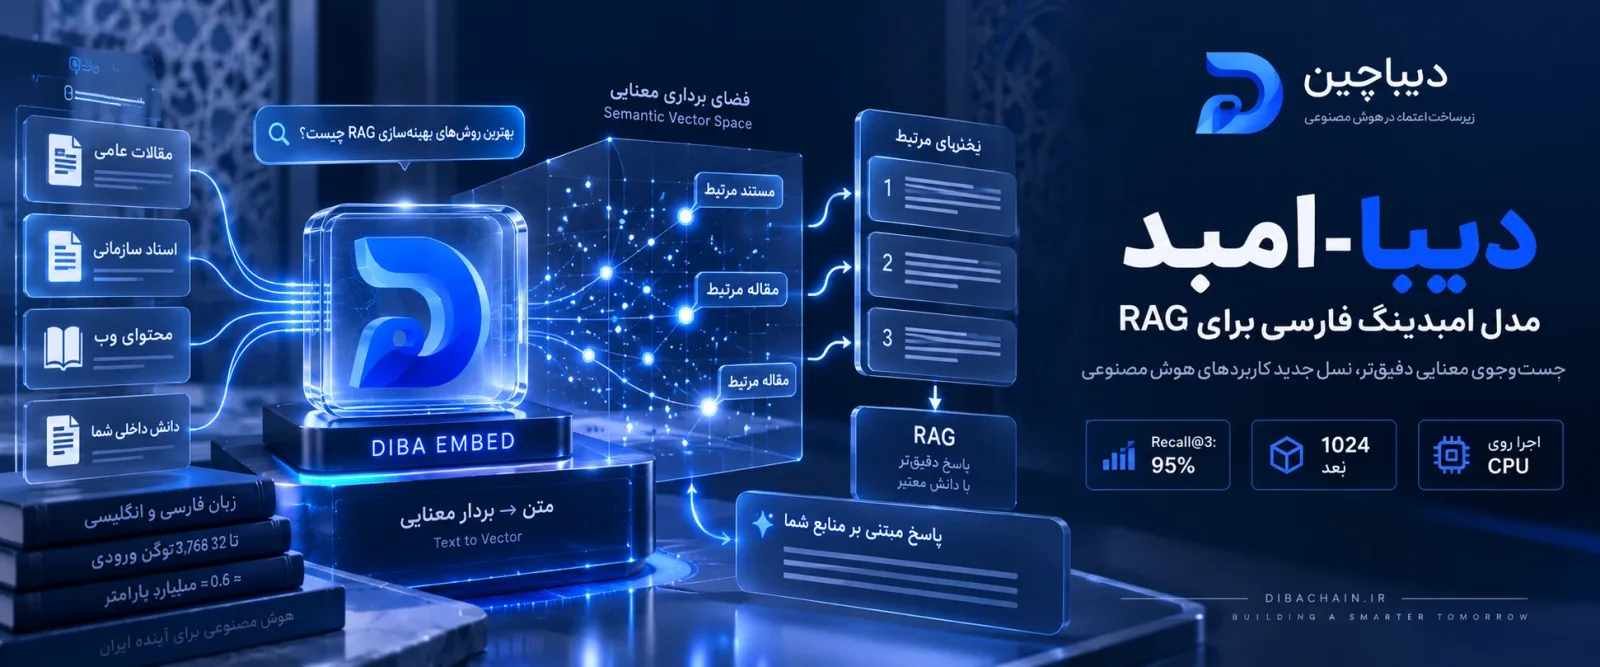
دیبا-امبد متنِ فارسی و انگلیسی را به بردارهای عددی تبدیل میکند تا متنهای هممعنا در فضای برداری به هم نزدیک شوند. با این کار میتوانید جستوجوی معنایی، بازیابی برای RAG، تطبیقِ پرسشهای پرتکرار، خوشهبندی و بازچینشِ نتایج بسازید — به فارسی، انگلیسی و میانِ این دو.
کارایی روی فارسی
دیبا-امبد روی ۴۰۰ جفت پرسش و پاسخِ فارسی سنجیده شد؛ هر پرسش باید پاسخِ درستِ خود را از میانِ کلِ مجموعه بازیابی میکرد:
| معیار | نتیجه |
|---|---|
| Recall@1 | ۸۲٪ |
| Recall@3 | ۹۵٪ |
| MRR | ۰٫۸۹ |
در ۹۵٪ موارد، پاسخِ درست میان سه نتیجهٔ نخست است — کافی برای یک RAG فارسیِ قابلاتکا. مشخصات: حدود ۰٫۶ میلیارد پارامتر، بردارِ ۱۰۲۴ بُعدی (قابل کاهش تا ۳۲ با Matryoshka)، پشتیبانی از ورودیِ تا ۳۲٬۷۶۸ توکن، و اجرا روی CPU.
چرا برای RAG فارسی مهم است؟
در معماریِ RAG، ابتدا امبدینگ مرتبطترین بخشهای دانشِ شما را پیدا میکند و سپس یک مدلِ زبانی مانند دیبا پاسخ را بر پایهٔ همان بخشها میسازد. اگر امبدینگ بخشهای اشتباه را بازیابی کند، حتی بهترین مدلِ زبانی هم پاسخِ غلط میدهد. دقتِ بالای دیبا-امبد روی فارسی، همان حلقهٔ گمشدهٔ RAG فارسیِ باکیفیت است.
پرسشهای متداول
دیبا-امبد برای RAG فارسی مناسب است؟
بله؛ با Recall@3 برابر ۹۵٪ و MRR برابر ۰٫۸۹ روی آزمون فارسی، پایهای قابلاتکا برای جستوجو و RAG فارسی است.
آیا روی CPU اجرا میشود؟
بله؛ حجمِ وزنها حدود ۱٫۲ گیگابایت است و فایلهای GGUF آماده برای اجرای CPU با llama.cpp دارد.
منابع معتبر و مطالعهٔ بیشتر
نقش دیباچین
مدلهای خانوادهٔ دیبا ساختهٔ دیباچین است؛ اگر میخواهید این مدلها را روی زیرساختِ خودتان مستقر کنید، روی دادهٔ سازمانی تنظیم کنید یا در محصولتان بهکار بگیرید، با ما تماس بگیرید و همهٔ مدلهای دیباچین را ببینید.